Sharper 研究团队解决方案

跨越所有来源开展研究,获得可验证的答案

总结单篇论文或综合整个文献集。探索概念与联系、比较发现、检查引用,并把证据转化为可编辑的研究成果。

打开发现背后引用的来源上下文,核查论文的实际表述,并让人的判断始终参与研究过程。

一句话,交付完整成果。

用自然语言说清目标。Sharper 会检索可信来源、完成分析,并生成可审阅、可编辑、可复用的成果。
  1. 文献综述

    从论文集到可编辑、带引用的文献综述

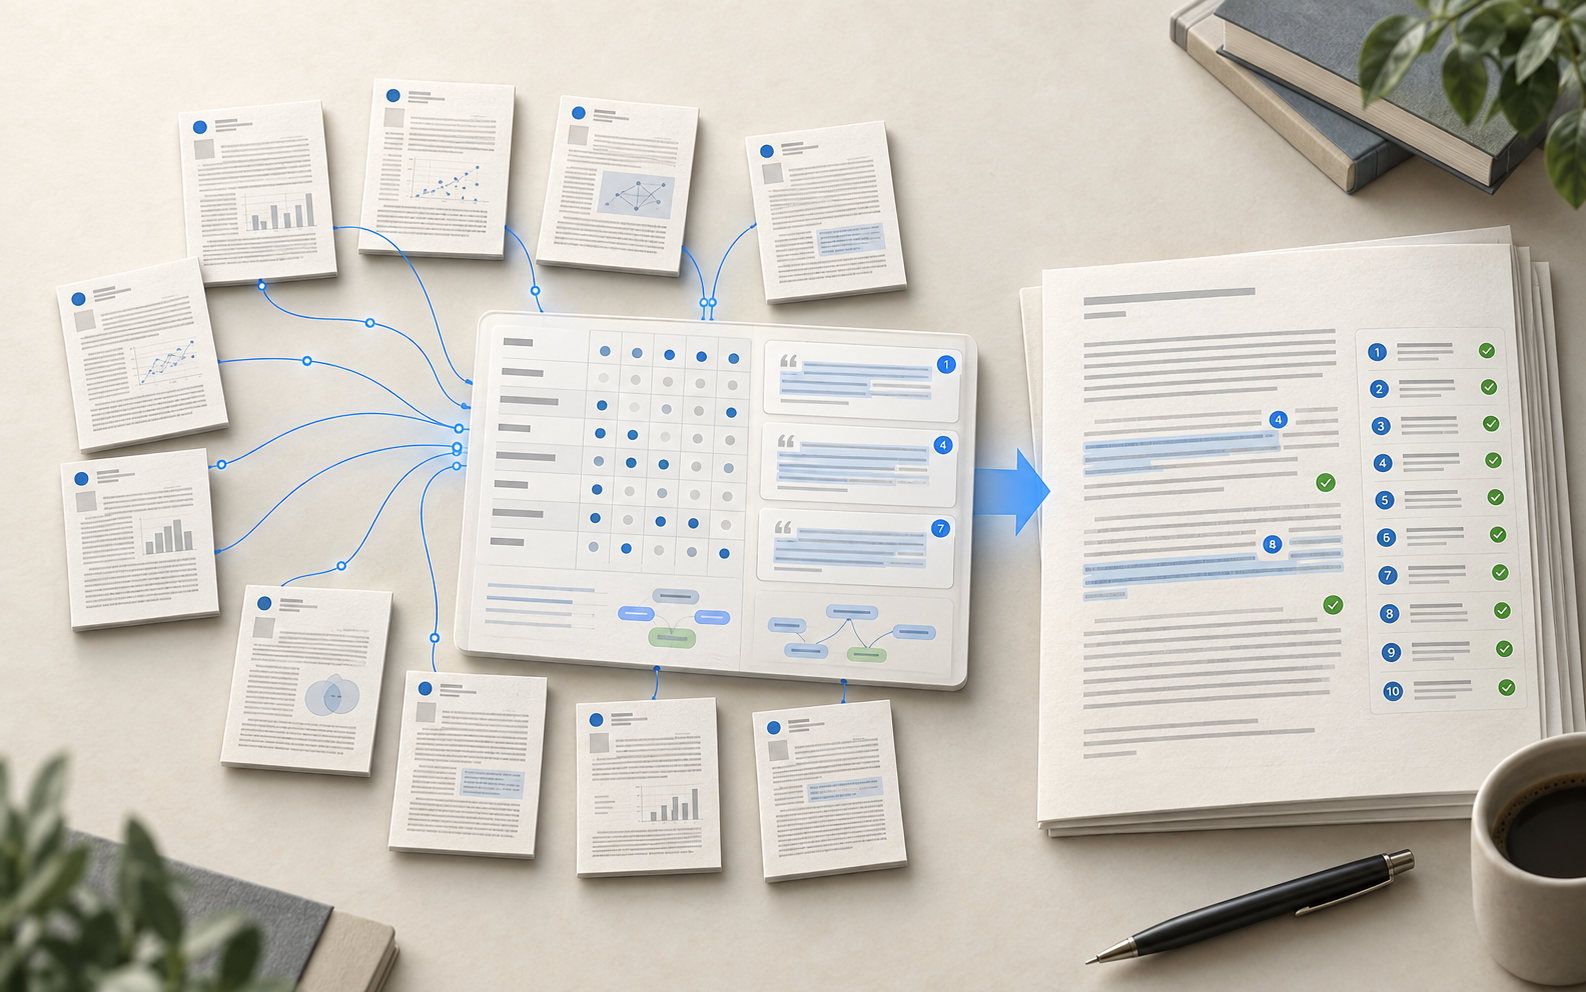
    以一致方式阅读每篇论文,探索概念与图谱联系,比较方法和局限,再起草可供修改、带引用的文献综述或相关工作章节。

    了解具体做法
    Ten research papers connected to an AI comparison workspace and a literature review with source-linked citations

    把这些论文综合成一篇带引用的文献综述。

    KB
  2. 知识库问答

    在你的所有文件中获得有据可依的答案

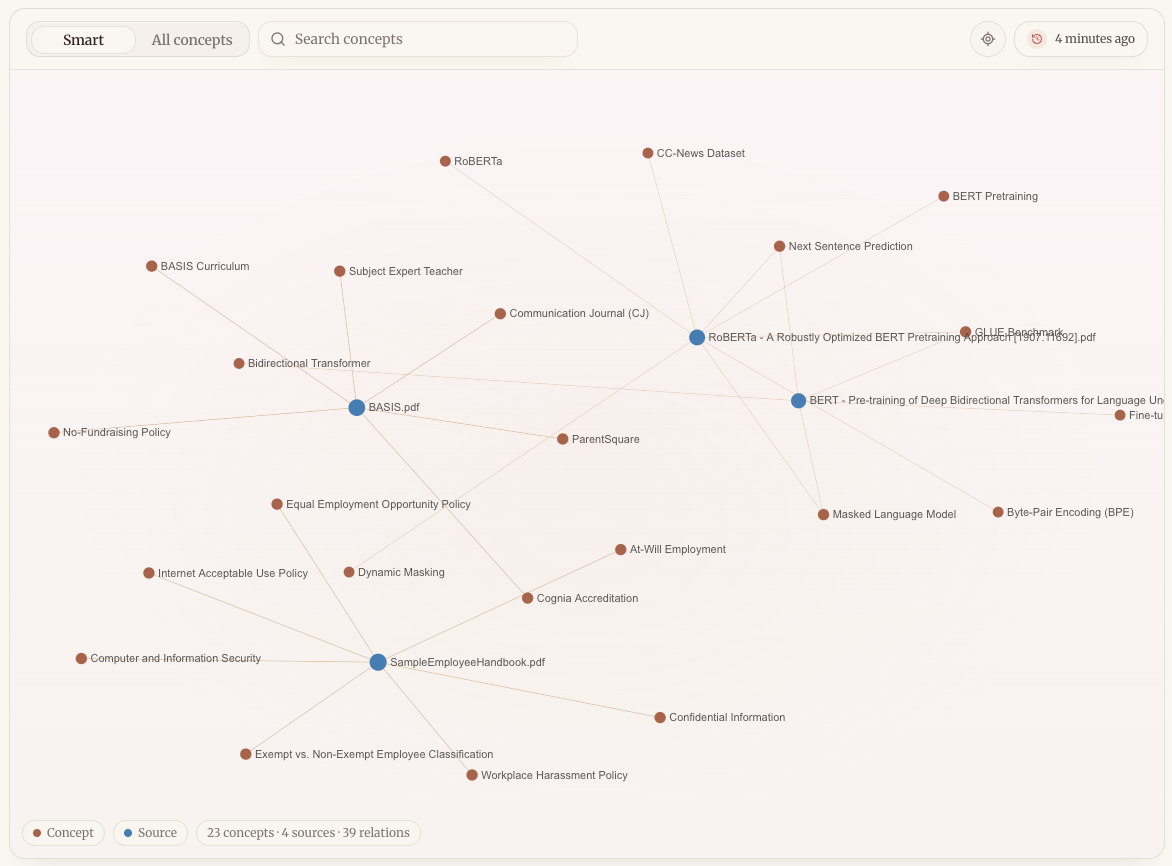
    用你的文档搭建知识库,然后获得基于来源的答案——每个论断都链接到其确切出处。

    了解具体做法
    Sharper knowledge graph connecting uploaded research papers, handbooks, and extracted concepts

    仅使用我们的内部文档来回答这个问题。

    KB
  3. 对比分析

    从零散文档到并排比较

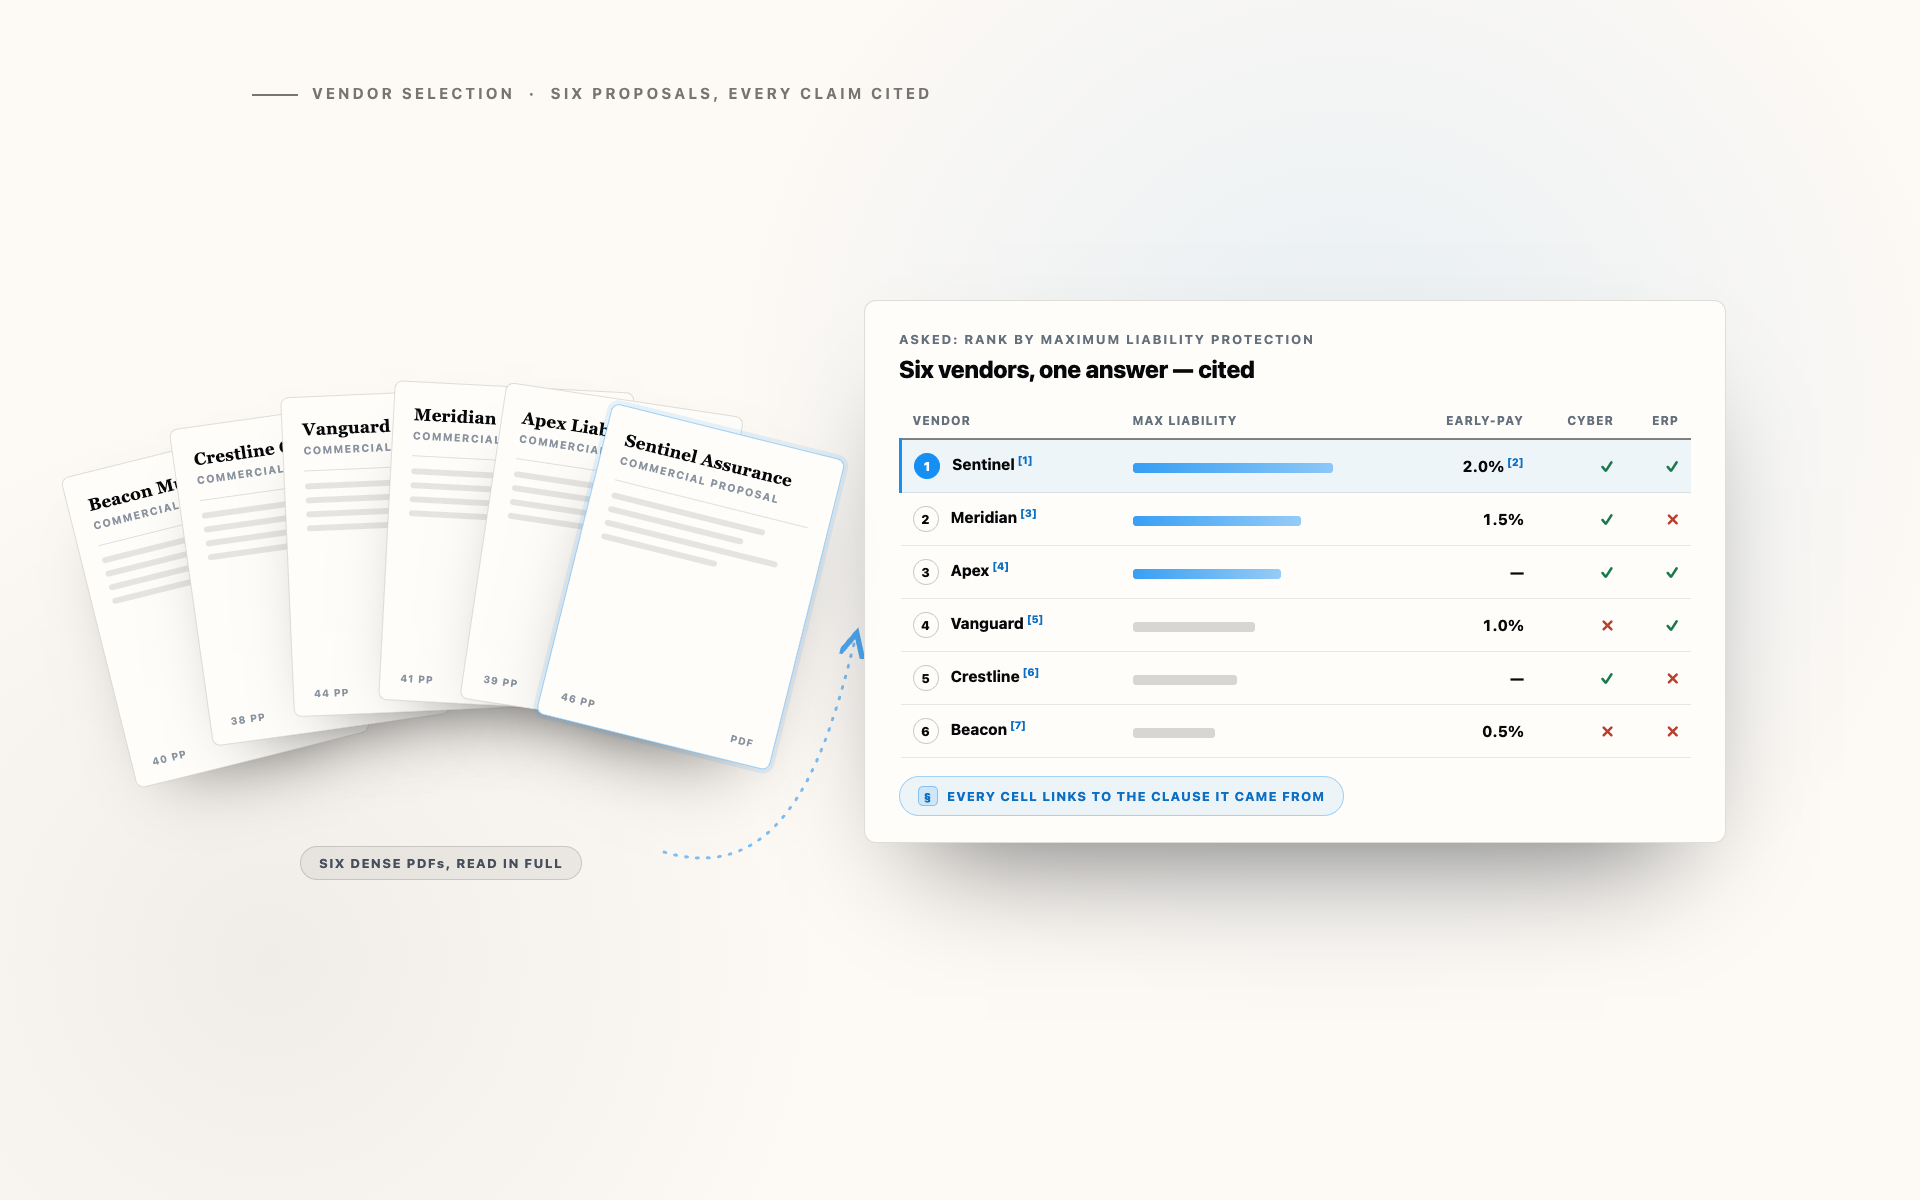
    把一组方案或报告整理成结构化的并排比较,每个数据点都可追溯到来源。

    了解具体做法
    Six fanned vendor proposal documents flowing into a ranked comparison matrix with citation markers on every cell and the winning vendor highlighted

    把这些方案并排比较,并为每个数字标注来源。

    KB

常见问题

关于 Sharper 如何处理你的来源与交付物的常见问题解答。

如何确保答案有据可依、可核实?

每个答案都与你来源中的确切段落相关联,让你可以核实每项主张。当 Sharper 采用检索而非通读整份文件时,会引用检索到的段落。

Sharper 能分析哪些文件类型?

PDF、Word 文档、电子表格、演示文稿和网页——它会跨这些内容进行阅读,并综合出一份可追溯的交付物。

它能同时比较多份文档吗?

可以。把一组报告或方案交给它,它会构建结构化的并排比较,每个数据点都可追溯到来源。

我们的数据会被用于训练 AI 模型吗?

不会。你的文档只用于回答你的问题——绝不会用于训练基础或通用 AI 模型。

让下一个研究工作流真正运转起来。

从你信任的资料开始,再让 Sharper 交付你需要的成果。

开始工作